
NEWS
最新消息
智能所-臺語 AI 進入全民應用新階段!Breeze-ASR-26 讓高效能臺語語音辨認成為創新起點
2026-09-07
【陽明交通大學,2026 年 8 月 21 日】臺語 AI 發展已進入高效能模型可直接支援應用創新的新階段。Breeze-ASR-26 是由陽明交通大學產創學院人工智慧語音研發中心與聯發科創新基地共同合作完成,並由雙方共同推動開源的高效能臺語語音辨認模型。高效能臺語語音辨認能力如今已可直接取得。隨著 Breeze-ASR-26 公開,Breeze-ASR-26 已建立可直接支援下游應用的技術基礎。從學生、教師、研究團隊到新創與產業開發者,都可直接運用既有模型能力,將研發資源投入 App、Edge AI、教育、醫療與智慧服務。臺語 AI 的下一階段,已經進入「誰能做出真正有價值的應用」。
這項轉變的基礎,是臺語已具備一套效能足以支撐後續開發的語音辨認模型。在 Breeze Taigi 公開 Benchmark 中,Breeze-ASR-26 的平均字元錯誤率(Character Error Rate, CER)為 30.13%,在相同測試條件下低於教育部臺灣台語輸入法 30.70%、Yating 32.11%、Gemini 3 Flash 32.52% 與 Breeze ASR 25 的 49.99%,為五套受測系統中最低。這項結果的意義不只在於 Benchmark 領先,更在於臺語語音辨認已有一個經公開測試驗證、可直接取得並持續開發的技術起點。
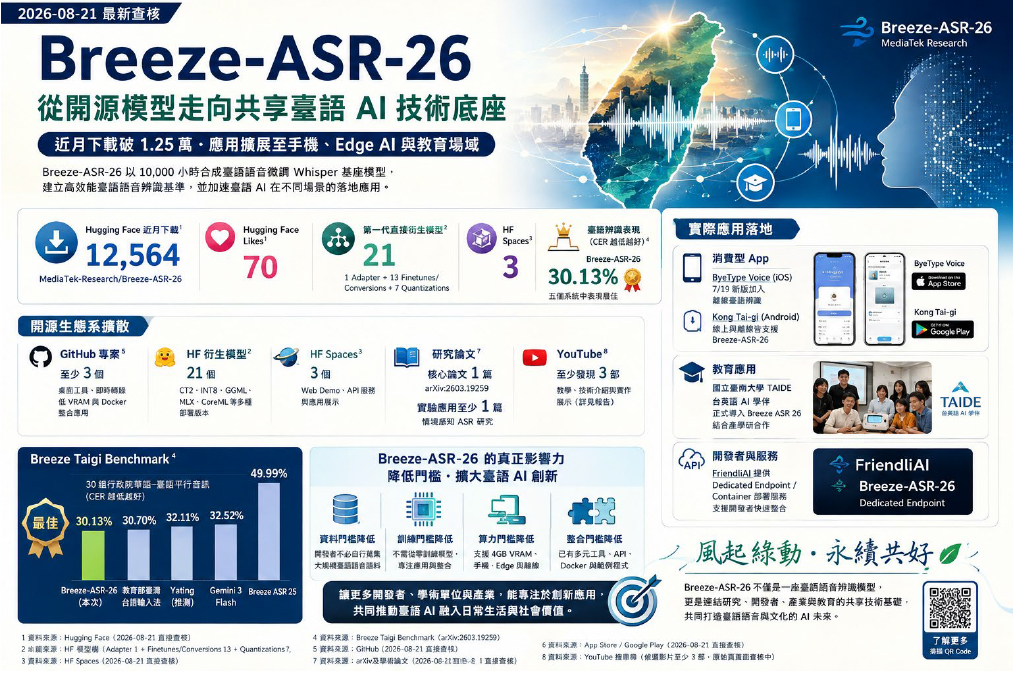
從「先做模型」到「直接做應用」 臺語 AI 創新起跑線已改變
這項成果由陽明交通大學產創學院人工智慧語音研發中心與聯發科創新基地攜手研發並共同開源。Breeze-ASR-26 讓臺語學習工具、智慧客服、醫療語音助理與文化保存服務等應用,可以直接建立在成熟的臺語語音辨認能力之上。Breeze-ASR-26 以 Whisper multilingual framework 為基礎,使用約 10,000 小時合成臺語語音進行微調。模型公開後,下游團隊可直接運用既有臺語語音辨認能力,將研發重心轉向領域調適、量化、Edge deployment、使用者介面與產品整合。這使臺語 AI 的競爭焦點,已經從重複建置基礎模型轉為應用創新與實際需求。
Benchmark 證明模型「可用」 真正的 Impact 是讓更多人開始創造應用
Breeze Taigi Benchmark 的公開結果提供了關鍵技術佐證。Breeze-ASR-26 的 CER 為 30.13%,在五套受測系統中最低;CER 越低代表辨認錯誤越少。對應用開發而言,這項結果所回答的核心問題是:臺語是否已有一套效能足以讓其他團隊直接往下開發的語音辨認模型?目前的公開測試結果顯示,公開結果已明確證實。當基礎能力可以直接取得,有限的研發資源便能進一步投入產品、服務與場域創新。
12,564 次近月下載、21 個衍生模型 開源效應已形成
模型公開後的生態發展,更顯示這項技術已走出實驗室。截至 2026 年 8 月 21 日,MediaTek-Research/Breeze-ASR-26 在 Hugging Face 顯示近月下載 12,564 次、70 Likes;官方 model tree 已形成 21 個第一代直接衍生模型,另有 3 個 Hugging Face Spaces。從 CTranslate2、GGML、INT8、MLX、CoreML 到 WhisperKit,社群正把同一套臺語語音辨認能力帶往伺服器、個人電腦、手機與 Edge 裝置。開發者的核心任務,已經從「重新訓練一套臺語模型」轉為「把臺語 AI 帶進真正的產品與服務」。
從 App 到教育現場 臺語 AI 已已進入真實使用情境
這項轉變已反映在實際應用。ByeType Voice 已加入 Breeze-ASR-26 離線臺語辨認;Kong Tai-gi 提供線上與離線臺語辨認;國立臺南大學「TAIDE 台英語 AI 學伴」正式導入 Breeze ASR 26;FriendliAI 亦提供 Breeze-ASR-26 Dedicated Endpoint。從手機 App、Edge AI 到教育與開發者服務,一條由「開源模型」通往「實際應用」的臺語 AI 生態正已形成。這些案例的重要性不只是增加應用數量,而是顯示臺語語音辨認正成為可重複利用、可持續擴充的 AI 基礎能力。
資料說明|12,564 為 Hugging Face「Downloads last month」,非歷史累積下載;21 個直接衍生模型不代表 21 個獨立採用組織。30.13% 為 Breeze Taigi 公開測試集的 CER,不應換算為 69.87%「準確率」,亦不可與其他資料集的辨認率直接比較。
主要來源|Breeze Taigi(arXiv:2603.19259)、MediaTek Research Hugging Face、Speech AI Research Center Hugging Face、Apple App Store、Google Play、國立臺南大學、GitHub、FriendliAI。資料查核日期:2026-08-21。